Microsoft выпустила локальный AI для кода
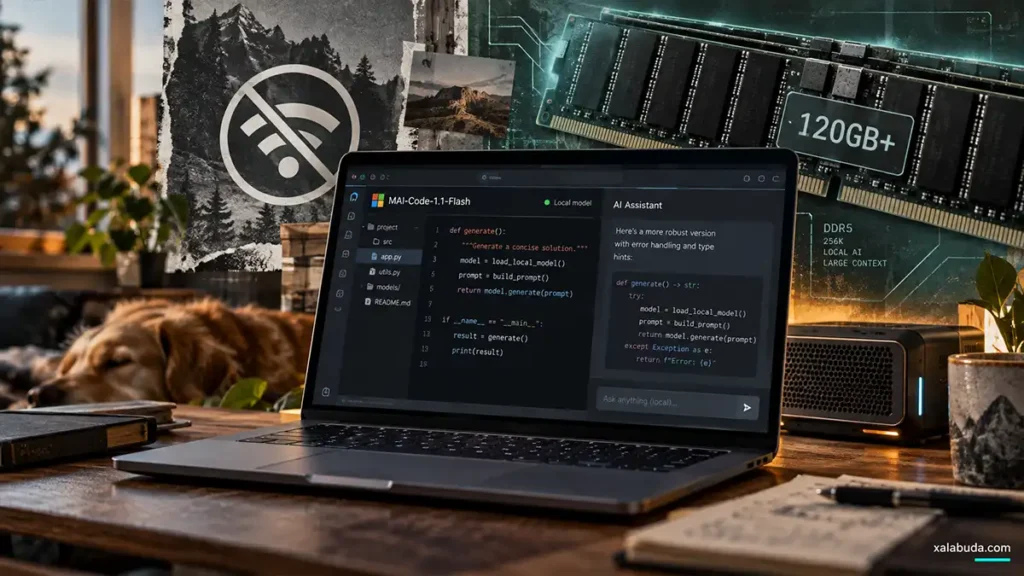
Microsoft сделала MAI-Code-1.1-Flash доступной для локального запуска: AI-модель для программирования теперь может обрабатывать запросы на компьютере пользователя. Но аппаратные аппетиты остались внушительными. Для лучшей производительности компания рекомендует устройства с более чем 120 ГБ оперативной памяти — даже после серьёзного уменьшения модели.
В анонсе локальной версии от 7 октября Microsoft сообщает о сохранении контекстного окна 256K токенов. Квантование уменьшает точность представления весов, сокращая занимаемый ими объём. Компания называет его 3-битным, а в описании тестовой конфигурации уточняет: использована смешанная точность, в среднем около 3,3 бита на вес. Размер модели составил примерно 53 ГБ — на 80% меньше версии BF16.
Размер модели, расход памяти при запуске и рекомендованный объём RAM — разные показатели:
| Показатель | Объём | Что означает |
|---|---|---|
| Размер квантованной модели | Около 53 ГБ | Объём самой модели |
| Пиковое потребление в тесте | 75,5 ГБ | Результат на Surface Laptop Ultra при контексте 256K |
| Рекомендация Microsoft | Более 120 ГБ RAM | Объём памяти устройства для лучшей производительности |
Последняя цифра — рекомендация, а не опубликованный жёсткий минимум. Но и наличие 128 ГБ обычной RAM не гарантирует скорость, показанную Microsoft. В тестовом Surface используется объединённая память CPU и GPU; в системе с дискретной видеокартой важны её собственная видеопамять и расходы на передачу данных. Организация памяти имеет значение и для других сценариев локального AI на RTX и DGX.
В испытаниях Microsoft квантованная версия получила 70,8% в SWE-Bench Verified против 72,6% у BF16, а в Terminal-Bench 2.1 — 66,29% против 62,9%. Это внутренние результаты для выбранных задач.
Показательной витриной стал Surface Laptop Ultra с NVIDIA RTX Spark и 128 ГБ объединённой памяти в старшей конфигурации. Её цена в США — около $5899. Сам ноутбук представили ещё 31 мая, а 7 октября открыли предзаказы; доступность заявлена с 16 октября. Этот Surface служит примером подходящего оборудования, а не обязательной покупкой для запуска модели.
До конца октября Microsoft планирует открыть экспериментальный доступ к локальной MAI-Code-1.1-Flash в приложении GitHub Copilot, Copilot CLI и Visual Studio Code. Предусмотрены ручной выбор локальной модели и автоматическое распределение задач между компьютером и облаком.
Поэтому локальный запуск модели не означает, что весь сеанс Copilot будет автономным или весь код гарантированно останется на устройстве. В режиме Auto часть запросов может уйти облачным моделям, а инструменты агента могут обращаться к сети. Эти границы Microsoft отдельно объясняет в описании локальной работы Copilot.
Облачная MAI-Code-1.1-Flash уже используется в GitHub Copilot. Для неё Microsoft заявляет на 25% более быструю выдачу токенов и на 25% меньший их расход относительно предшественницы. Это сравнение облачных версий, а не обещание такого же ускорения на домашнем ПК.