Локальные нейросети: как работают и какие модели выбрать
Локальная нейросеть может отвечать на вопросы, редактировать текст и разбирать документы без отправки каждого запроса в облако. Но модель, которая хорошо выглядит в рейтинге, не обязательно удобно работает на домашнем компьютере: всё решают доступная память, программа запуска и конкретная задача.
Ниже — ориентиры по оборудованию, семь вариантов моделей и два способа первого запуска. Подборка актуальна на 29 октября 2026 года. Это кандидаты для сравнения, а не результаты собственного тестирования с расставленными местами.
Что такое локальная нейросеть и чем она отличается от облачной
Локальная нейросеть — модель искусственного интеллекта, вычисления которой выполняются на вашем компьютере или другом контролируемом устройстве. Файлы модели хранятся локально, а для обработки запросов используются процессор, видеокарта и память этой системы.
В этой статье основной акцент — на языковых моделях, или LLM. Они генерируют текст, переводят, помогают с кодом и анализируют материалы. Существуют также локальные модели для изображений и речи, но им могут требоваться другие программы и оборудование.
| Критерий | Локальный ИИ | Облачный ИИ |
|---|---|---|
| Где выполняются вычисления | На вашем оборудовании | На серверах поставщика |
| Интернет | Для обычного чата часто не нужен после загрузки компонентов | Обычно необходим |
| Выбор моделей | Ограничен совместимостью и ресурсами ПК | Зависит от сервиса и тарифа |
| Данные | Можно организовать локальную обработку | Обрабатываются по правилам провайдера |
| Затраты | Оборудование, электричество, настройка | Подписка, API или другие условия |
Локальный запуск не означает автоматической изоляции. Программа может обращаться за обновлениями, использовать облачные модели или подключать внешние инструменты. Проверять нужно выбранный режим, а не только название приложения.
Как работают локальные нейросети: модель, параметры и квантование
Для запуска нужны две разные вещи: обученная модель и совместимая программа. Qwen, Gemma и Phi — семейства моделей. Ollama и LM Studio загружают их и выполняют вычисления. Hugging Face — площадка, где размещены модели, их описания и файлы.
Веса модели — числовые параметры, полученные при обучении. Языковая модель использует их, чтобы последовательно генерировать токены: части слов, знаки и другие элементы текста. Обозначение 4B обычно указывает примерно на четыре миллиарда параметров, но само количество не определяет качество ответов.
Квантование уменьшает объём, занимаемый весами, за счёт менее точного представления чисел. Например, Q4_K_M обозначает один из вариантов квантования, часто используемых с GGUF. Это помогает экономить память, но может влиять на качество; результат зависит от модели и задачи.
Контекст — данные, доступные модели при подготовке ответа: запрос, история беседы, переданные фрагменты документов. Длинный контекст требует дополнительных ресурсов. Максимум из карточки модели не означает, что его получится использовать на любом ПК.
У моделей MoE при обработке токена активируется часть параметров. Это снижает вычислительную нагрузку, но не означает, что в памяти нужны только активные параметры: остальной набор весов тоже необходимо где-то разместить.
Какой компьютер нужен для запуска локальной нейросети
Размер скачивания не равен потреблению памяти. Помимо весов нужны рабочие буферы, данные контекста, память программы и операционной системы. Файл на 7 ГБ не является обещанием запуска на компьютере с 8 ГБ RAM.
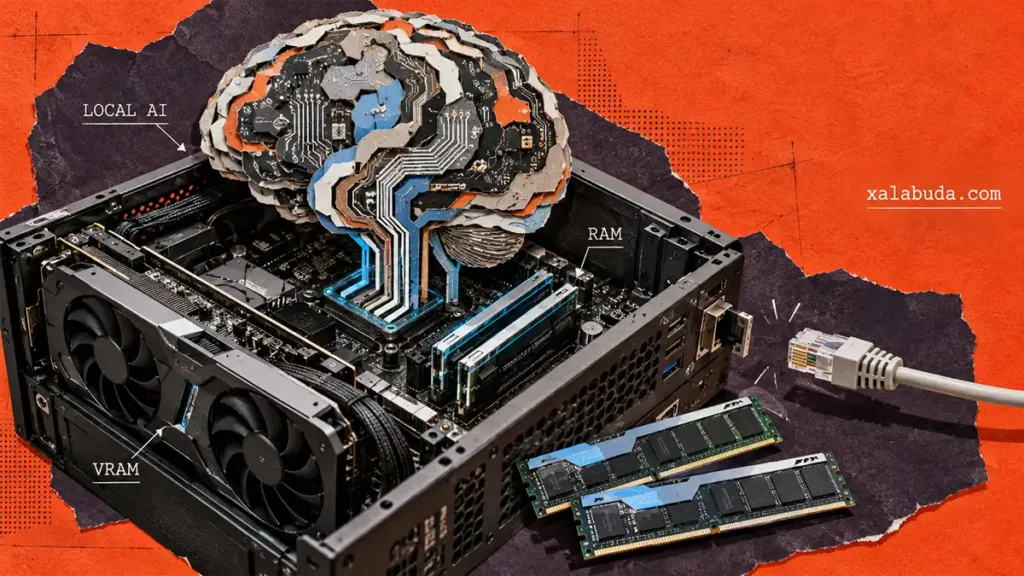
RAM — системная оперативная память, VRAM — память видеокарты. Их различия разобраны в материале про видеопамять и ОЗУ. Частичное размещение модели в RAM и VRAM возможно в совместимых программах, но может замедлять работу. У систем с объединённой памятью организация ресурсов другая.
| Конфигурация | С чего разумно начать |
|---|---|
| 8 ГБ RAM | Самые компактные модели примерно 0,8–2B, короткий контекст и совместимая программа |
| 16 ГБ RAM без дискретной GPU | Небольшие квантованные модели; сначала класс 3–4B, затем более крупные при наличии запаса |
| GPU с 8–12 ГБ VRAM | Квантованные варианты примерно 4–9B, проверяя полный расход памяти |
| GPU с 24 ГБ VRAM | Некоторые варианты класса 20–30B в квантовании, с учётом контекста |
| 32–64 ГБ RAM или объединённой памяти | Более крупные модели, если поддерживаются архитектура устройства и выбранный движок |
Это ориентиры для первого выбора, а не гарантированные требования. Например, LM Studio рекомендует от 16 ГБ RAM; совместимость также зависит от ОС и процессора. Запуск на CPU возможен, но большая модель может отвечать слишком медленно.
SSD ускоряет загрузку, однако не заменяет рабочую память. Для бюджетного знакомства лучше начать на имеющемся компьютере, а решение об апгрейде принимать после проверки своих задач.
Лучшие локальные нейросети в 2026 году: кандидаты под разные задачи
Одна «самая мощная локальная нейросеть» не закрывает все сценарии. Ниже — доступные варианты разного класса. Размеры относятся к опубликованным пакетам Ollama: для первых трёх строк с Q4_K_M и для остальных указанных вариантов. Другой формат или обновление пакета может изменить объём.
| Модель | Вариант Ollama | Размер по каталогу | Для чего рассмотреть |
|---|---|---|---|
| Qwen3.5 4B | qwen3.5:4b | Около 3,3 ГБ | Первый локальный помощник, тексты и короткие запросы |
| Qwen3.5 9B | qwen3.5:9b | Около 6,6 ГБ | Более ресурсоёмкий универсальный вариант |
| Gemma 4 12B | gemma4:12b | Около 8 ГБ | Текст, рассуждения и мультимодальные задачи |
| Phi-4-mini | phi4-mini:3.8b | Около 2,5 ГБ | Компактная текстовая модель для сравнения на своих примерах |
| gpt-oss-20b | gpt-oss:20b | Около 14 ГБ | Рассуждения и структурированные задания |
| Qwen3.8 27B | qwen3.8:27b | Около 18 ГБ | Сложные инструкции, документы и код на мощном ПК |
| Qwen3-Coder 30B | qwen3-coder:30b | Около 19 ГБ | Генерация, объяснение и исправление кода |
Qwen3.5 — удобный кандидат для первого сравнения благодаря нескольким размерам. Для слабого устройства можно посмотреть версии меньше 4B. Qwen3.8 27B требует уже заметного запаса памяти и не подходит в качестве универсального совета владельцу обычного ноутбука.
У Gemma 4 есть версии E2B, E4B, 12B, 26B A4B и 31B с разными возможностями. Поддержку изображений или аудио нужно проверять не только у модели, но и у программы запуска.
gpt-oss — отдельные модели OpenAI с открытыми весами, а не полная локальная копия ChatGPT. Разработчик указывает возможность запуска gpt-oss-20b в пределах 16 ГБ памяти, но это не обещание комфортной работы на любом ПК с 16 ГБ общей RAM.
Для кода стоит отдельно сравнить Qwen3-Coder с универсальными моделями. Для русского и украинского языков проверяйте собственные тексты: заявленная многоязычность не гарантирует одинакового качества во всех темах.
Где скачать локальные нейросети бесплатно
На Hugging Face размещены веса, карточки моделей, лицензии и разные варианты упаковки. В каталоге важно выбирать не просто знакомое название, а подходящий формат и надёжного издателя.
В библиотеке Ollama доступны подготовленные варианты с командами запуска. LM Studio позволяет искать и скачивать совместимые модели через графический интерфейс, в том числе из Hugging Face.
GGUF — распространённый формат для движков на базе llama.cpp. Встречаются также safetensors и сборки для MLX. Наличие файла модели ещё не означает, что любая программа сможет его открыть.
Бесплатная загрузка весов не равна отсутствию условий. У Gemma 4 и gpt-oss заявлена Apache 2.0; для выбранного выпуска и сторонней сборки всё равно проверяйте лицензию и сопутствующие условия. Открытые веса также не означают автоматически открытые данные обучения и полностью открытый процесс разработки.
Как установить и запустить локальную нейросеть
Через LM Studio — если нужен графический интерфейс:
- Скачайте LM Studio для своей ОС и проверьте системные требования.
- Установите приложение и необходимые компоненты движка.
- В разделе Discover найдите совместимую инструкционную модель, например Qwen3.5 4B.
- Выберите подходящее квантование, ориентируясь на доступную память и подсказки приложения.
- Скачайте модель, откройте Chat и загрузите её через выбор модели.
- Отправьте короткий запрос и оцените скорость и расход памяти.
Через Ollama — если удобнее терминал:
- Установите актуальную версию Ollama для Windows, macOS или Linux.
- Откройте терминал или PowerShell и выполните команду ниже.
- Дождитесь загрузки файлов, затем введите запрос в появившемся чате.
ollama run qwen3.5:4bЗдесь указан конкретный локальный вариант. Выбор другой модели, особенно помеченной как cloud, меняет место обработки запросов. Локальный запуск через Ollama не требует облачного API-ключа.
После загрузки модели и движка отключите интернет и повторите обычный текстовый запрос. Это проверит автономность данного сценария, но не всех интеграций. Если модель не помещается, выберите меньшую или сократите контекст. При низкой скорости проверьте поддержку GPU и фактическое использование памяти.
Ещё один вариант для Windows 11 рассмотрен в материале о запуске локального ИИ через Llama Windows.
Как выбрать нейросеть под свои задачи
Для первого знакомства практичнее небольшая модель, которая быстро отвечает, чем крупная, едва помещающаяся в память. Дальше сравните две-три модели на одинаковом наборе заданий:
- Тексты и перевод. Проверьте естественность языка, сохранение смысла и соблюдение объёма.
- Документы. Дайте материал с известными фактами и проверьте, не выдуманы ли выводы и цитаты.
- Код. Используйте небольшую воспроизводимую задачу и проверяйте результат запуском и тестами.
- Изображения. Выберите модель с визуальным входом и совместимый движок; обычная текстовая LLM фотографии не анализирует.
Записывайте время до начала ответа, скорость выдачи, ошибки и расход памяти. Учитывайте режим рассуждений и длину контекста: они могут заметно менять результаты.
Большое контекстное окно само по себе не превращает чат в надёжный поиск по библиотеке документов. Для этого нужны корректное извлечение текста и, при необходимости, отдельная система поиска по фрагментам — RAG.
Плюсы, ограничения и стоимость локального ИИ
Основные преимущества — автономность, контроль над конфигурацией и возможность обрабатывать данные без отправки запросов внешнему поставщику. При регулярной подходящей нагрузке локальный запуск может быть экономически удобен, особенно если компьютер уже есть.
Но бесплатные веса не отменяют расходов на электричество, накопитель, оборудование и настройку. Покупка мощной видеокарты ради редких запросов не обязательно выгоднее облачного сервиса.
Локальная модель тоже ошибается, выдумывает факты и не узнаёт свежие события автоматически. Поиск в интернете, вызов инструментов и доступ к файлам обеспечиваются дополнительными программами; эти возможности нужно настраивать отдельно.
Для чувствительных данных проверьте сетевые интеграции и хранение истории чата. Используйте проверенные приложения и сборки, а не случайные исполняемые файлы под видом модели. Предоставляйте инструментам только нужный доступ.
Лучший первый шаг — запустить небольшую модель и проверить её на своей работе. Если качества достаточно, дорогой апгрейд может не понадобиться. Если недостаточно, уже будет понятно, чего именно не хватает: памяти, скорости, возможностей модели или настройки всего процесса.