OpenAI добавит невидимые водяные знаки в тексты ChatGPT и Codex в ЕС
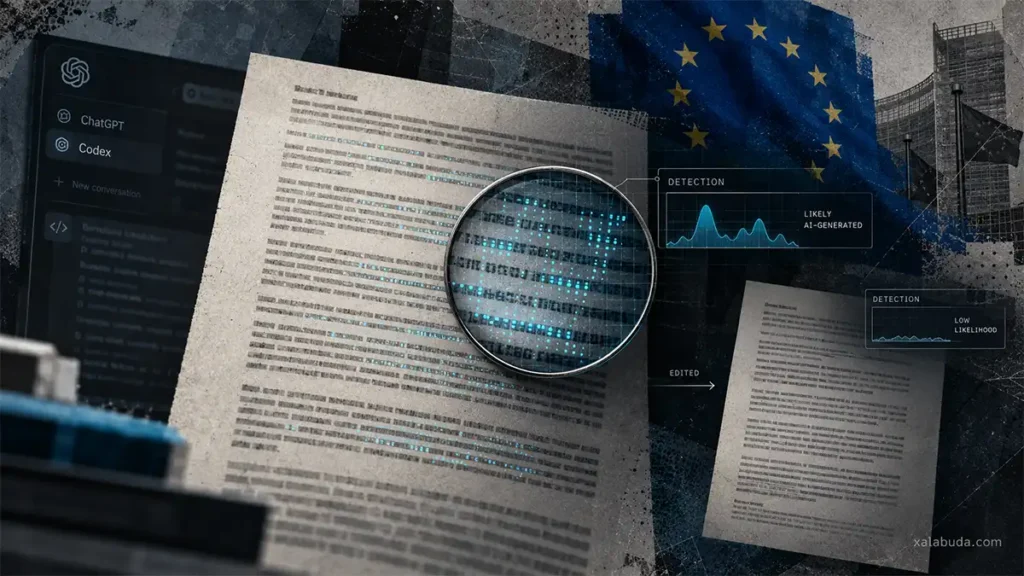
OpenAI добавит невидимые водяные знаки в подходящие текстовые ответы ChatGPT и Codex в Европейском союзе. Читатель не увидит метку, но специальный детектор сможет искать её статистический сигнал. Компания объявила об этом 5 октября: внедрение технологии textGrain намечено на ближайшие недели и связано с требованиями EU AI Act к прозрачности AI-контента.
Новый водяной знак ChatGPT не состоит из скрытых символов, необычных пробелов или специальной пунктуации. textGrain меняет вероятности выбора токенов — слов и их частей — во время генерации. На протяжении ответа эти решения образуют статистический рисунок, который проверяет детектор с соответствующим секретным ключом. Сходный принцип скрытой маркировки используется в SynthID-Text для Gemini.
При запуске OpenAI не будет включать маркировку по умолчанию во всём мире. Клиенты API с 5 октября могут добровольно активировать её для поддерживаемых моделей, но изначально она выключена. Детектор тоже не станет общедоступным: на первом этапе доступ получат только одобренные исследователи и экспертные организации.
Редактирование способно заметно ослабить сигнал. В одном из тестов OpenAI использовала маркированные англоязычные ответы из набора ELI5 длиной 400 токенов. Без изменений водяной знак обнаруживался примерно в 92% случаев. После замены 10% слов синонимами показатель падал до 66%, а после замены 25% — до 17%. Это результаты конкретного теста, а не универсальная точность распознавания любых текстов.
Имеют значение длина и содержание ответа. При целевом уровне ложных срабатываний 1% детектор находил метку примерно в 80% ответов по психологии длиной 200 токенов и примерно в 95% — при 400 токенах. В математических ответах результаты были заметно хуже: у модели меньше свободы выбора формулировок. Короткие фрагменты и код также сложнее снабдить надёжно обнаруживаемым водяным знаком.
Обычное копирование с сохранением формулировок само по себе не убирает статистический рисунок. Серьёзное перефразирование и перевод могут сделать обнаружение менее надёжным. При этом отсутствие сигнала не доказывает человеческое авторство: текст мог быть изменён, создан до внедрения маркировки или получен от модели, которая её не поддерживает.
Обнаруженная метка указывает на участие системы OpenAI в создании или обработке текста. Она не показывает, сколько материала написал или переработал человек, не подтверждает достоверность содержания и не раскрывает пользователя, аккаунт, запрос или переписку.
В своих тестах модели Astra компания не обнаружила заметной разницы в результатах бенчмарков с маркировкой и без неё. OpenAI также планирует открыть исходный код textGrain, но конкретную дату такого релиза пока не называет.