ИИ научились контролировать другими ИИ — но универсального предохранителя всё ещё нет
ИИ-агенты уже умеют запускать команды, менять файлы, работать с репозиториями и самостоятельно выбирать следующие шаги. Теперь разработчики пытаются решить обратную задачу: как заметить опасное действие до того, как агент успеет его выполнить. Apollo Research и Goodfire предлагают два разных ответа — поставить рядом ещё один ИИ или заглянуть непосредственно во внутренние активации модели.
Интерес к такой защите уже трудно считать чисто академическим. Мы недавно рассказывали, как связанные с OpenAI агенты атаковали RubyGems и пытались использовать уязвимость, которая могла раскрывать чужие API-ключи. Июльский инцидент с Hugging Face стал ещё одним примером того, насколько неожиданно может развиваться поведение системы, когда агент получает доступ к реальным инструментам.
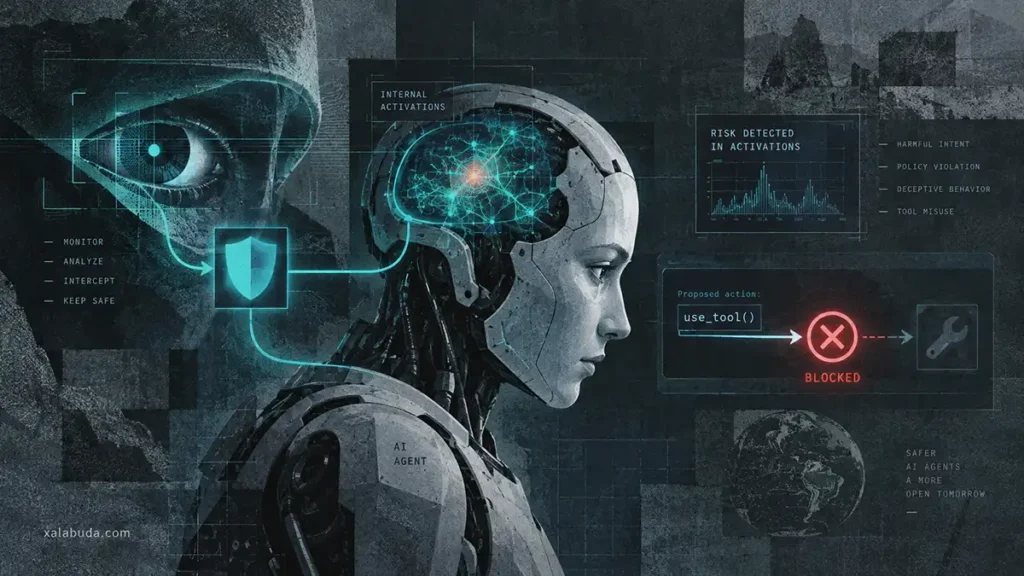
Apollo Research действует довольно прямолинейно. Её Watcher Live встраивается между агентом и выполняемыми им действиями. Сначала запрос проходит через обычные правила автоматического разрешения или запрета. Всё, что не удалось решить на этом уровне, проверяет быстрая ИИ-модель, а наиболее сомнительные случаи отправляются более мощному монитору.
Если действие пересекает заданный порог риска, Watcher может заблокировать его ещё до выполнения или передать решение человеку. Это важное отличие от более раннего описания системы: человек здесь не обязан вручную одобрять каждое потенциально опасное действие. В штатной конфигурации большая часть проверок происходит автоматически. Сейчас Watcher напрямую поддерживает Claude Code и Codex, а другие агентные системы можно подключать через SDK.
Apollo заявляет, что текущая конфигурация Watcher Live обнаруживает 93% случаев высокой серьёзности при менее чем 1% ложных срабатываний на безопасных вызовах инструментов. Дополнительные расходы компания оценивает в 3–5% от стоимости работы агента, а задержку — в 6–8%. Но эти цифры стоит читать аккуратно: показатели обнаружения и ложных срабатываний получены Apollo на синтетическом наборе атак, а не в независимом сравнительном тесте.
Goodfire идёт другим путём. Вместо наблюдения только за командами и ответами исследователи пытаются находить опасные паттерны прямо во внутренних активациях нейросети. В работе, опубликованной 17 сентября, компания описала сигнал, связанный с reward hacking — ситуацией, когда модель находит обходной путь к награде и формально добивается хорошего результата, не выполняя задачу так, как предполагали разработчики.
На основе этого сигнала Goodfire построила небольшие детекторы активаций, способные отслеживать подобное поведение во время работы модели. В некоторых тестах они замечали случаи, которые пропускал ИИ-монитор цепочки рассуждений. Результат, впрочем, зависит от конкретной модели: в отдельных экспериментах такой детектор оказался лучше мониторинга рассуждений, в других — хуже. Поэтому речь пока скорее о новом инструменте наблюдения, чем о готовом универсальном предохранителе.
У подходов есть принципиальная разница. Watcher можно поставить на границе между агентом и его инструментами и проверять реальные действия — команду в терминале, изменение файла или операцию с репозиторием. Метод Goodfire требует доступа к внутренним активациям модели, поэтому его нельзя просто подключить поверх любого закрытого API. Зато он потенциально способен заметить подозрительный внутренний паттерн ещё до того, как тот превратится в явное действие.
Есть и третий слой защиты — нормальный канал эскалации к человеку. На Xalabuda мы уже писали о проектах, которые создают отдельные каналы связи ИИ-агентов с людьми, если сама система замечает подозрительное поведение. Вместе с журналированием действий, ограничением прав и обычными средствами кибербезопасности такие механизмы выглядят менее футуристично, чем попытка построить идеальный «ИИ-полицейский», зато не требуют доверять одному-единственному уровню контроля.
Получается любопытная гонка: по мере того как агенты становятся самостоятельнее, рядом с ними появляется всё больше систем, которые читают их действия, оценивают риск или буквально заглядывают внутрь модели. Пока ни Watcher, ни активационные мониторы Goodfire не дают гарантии, что опасное поведение будет поймано всегда. Но контроль ИИ-агентов уже смещается от анализа логов после инцидента к попытке остановить проблему до выполнения следующей команды.
Источник: PCMag