NVIDIA показала, как сократить генерацию FLUX 3 Image Klein с 22 до 6 секунд
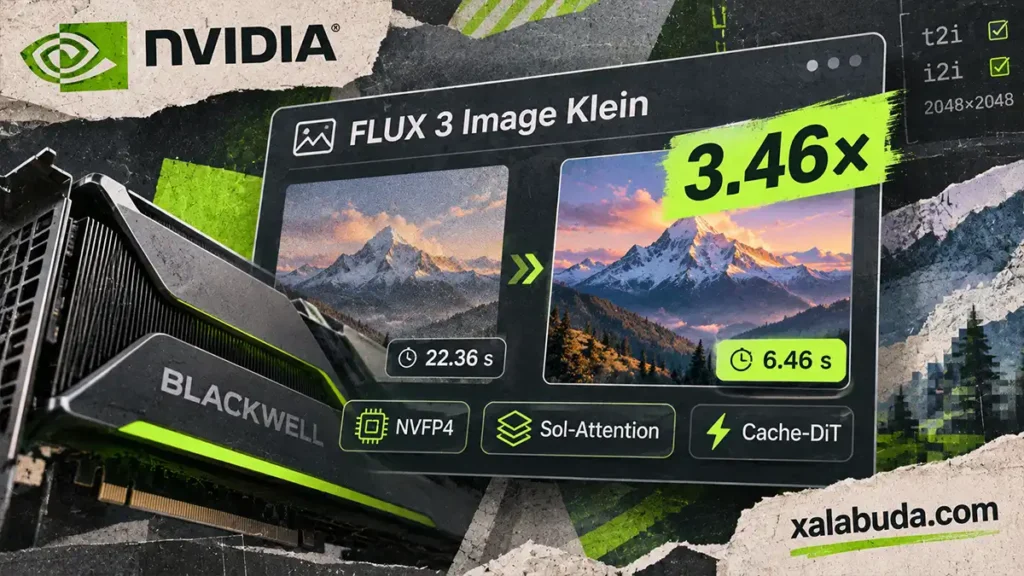
NVIDIA показала, как существенно ускорить генерацию и редактирование изображений с помощью нейросети FLUX 3 Image Klein. Инженеры компании оптимизировали работу модели на GPU архитектуры Blackwell и добились ускорения до 3,46 раза при создании изображений по тексту и до 4,45 раза при редактировании готовых изображений.
Результаты получены на одной серверной NVIDIA B200 при разрешении 2048 × 2048 пикселей. Для этого разработчики совместили несколько технологий: квантование NVFP4, оптимизированные вычислительные ядра, разреженное внимание и кеширование промежуточных результатов. Все методы и инструкции запуска NVIDIA раскрыла в техническом руководстве по ускорению FLUX 3.
Речь не о выпуске новой нейросети. FLUX 3 Image Klein разработана Black Forest Labs, а NVIDIA исследовала способы повысить её производительность на собственном оборудовании. Вместе с результатами тестирования компания опубликовала команды запуска и конфигурационные файлы для TensorRT LLM VisualGen.
Как устроена FLUX 3 Image Klein
FLUX 3 Image Klein предназначена для генерации изображений по текстовым запросам и редактирования существующих изображений. В её архитектуре используются Qwen3-VL-4B-Instruct для обработки текстовых условий, диффузионный трансформер (DiT) для формирования изображения и автоэнкодер для преобразования визуальных данных.
Текст, создаваемое изображение и дополнительные изображения-образцы проходят отдельные этапы обработки. Затем модель объединяет информацию с помощью механизма совместного внимания (joint attention).
Black Forest Labs предлагает две основные конфигурации:
- Base предназначена для сценариев, где важна точность воспроизведения. В испытаниях NVIDIA использовались 50 шагов удаления шума и коэффициент CFG 3,5.
- Distilled ориентирована на более быструю генерацию. В опубликованных тестах она выполняла 16 шагов удаления шума без CFG.
Разница в производительности довольно существенная. На одной NVIDIA B200 при разрешении 2048 × 2048 пикселей Base создавала изображение за 14,70 секунды, тогда как Distilled требовалось всего 2,71 секунды. Эти результаты получены при использовании NVFP4, стандартного механизма внимания и компиляции.
Основное время модель тратит на последовательное удаление шума. Для Base этот этап занимал 96,8% общего времени генерации, а для Distilled — 84%. Поэтому NVIDIA сосредоточилась прежде всего на ускорении диффузионного трансформера.
Какие технологии помогли ускорить FLUX 3 Image Klein
Главным инструментом оптимизации стала среда TensorRT LLM VisualGen. Она позволяет выбирать точность вычислений, настраивать механизмы внимания, кешировать промежуточные результаты и распределять нагрузку между несколькими GPU.
Квантование NVFP4 и оптимизация вычислительных ядер
Первый способ ускорения заключается в переходе с BF16 на NVFP4. Этот формат позволяет выполнять часть вычислений с меньшей числовой точностью, сокращая потребность в вычислительных ресурсах.
По результатам NVIDIA, NVFP4 обеспечил ускорение до 1,62 раза при генерации изображений по тексту и до 1,58 раза при редактировании. При этом влияние квантования на итоговое изображение необходимо оценивать отдельно: меньшая точность вычислений не гарантирует полного совпадения результатов.
Дополнительный прирост обеспечили ядра PrimsTS GEMM из FlashInfer. Они оптимизируют операции умножения матриц, объединяют последовательные вычисления и уменьшают накладные расходы.
На NVIDIA B200 такая реализация оказалась в 1,02–1,10 раза быстрее другой реализации NVFP4 GEMM в TensorRT LLM. Этот показатель относится к отдельному этапу оптимизации, а не к общему ускорению модели.
Похожий принцип уменьшения вычислительной нагрузки применяется и в локальных AI-моделях. Подробнее о квантовании, памяти и требованиях к оборудованию мы рассказывали в материале о локальных нейросетях. Однако результаты серверных GPU нельзя напрямую переносить на домашние компьютеры.
Ускорение механизма внимания
Следующим направлением стала оптимизация attention, механизма, который позволяет модели учитывать взаимосвязи между элементами обрабатываемых данных.
В тестах с NVFP4 при разрешении 2048 × 2048 пикселей стандартный механизм внимания BF16 занимал около 60% времени работы вычислительных ядер DiT. NVIDIA сравнила несколько альтернативных реализаций:
- cuDNN FP8 Attention ускорила генерацию в 1,08 раза для Base и в 1,09 раза для Distilled.
- VC-Attention FP8 показала ускорение в 1,18 раза для Base и в 1,16 раза для Distilled.
- Sol-Attention использует разреженное внимание для сокращения вычислений. Для Base ускорение этапов удаления шума и декодирования составило от 1,24 до 1,30 раза.
У Sol-Attention есть компромисс между скоростью и сохранением визуальных деталей. Если первые 16 шагов выполнять со стандартным вниманием, ускорение составляет приблизительно 1,24 раза. При сокращении этого периода до 12 шагов показатель увеличивается до 1,30 раза, но различия между изображениями становятся заметнее.
Поэтому наиболее быстрая конфигурация не всегда оказывается предпочтительной. Для задач, где важно сохранить композицию и мелкие детали, более осторожная настройка может быть полезнее.
Cache-DiT сокращает количество повторных вычислений
Ещё один метод ускорения — Cache-DiT. Он позволяет повторно использовать промежуточные результаты трансформера между шагами удаления шума, вместо того чтобы каждый раз выполнять все вычисления заново.
Для применения технологии не требуется переобучать модель или изменять её веса. Разработчик задаёт параметры кеширования, которые определяют допустимые условия повторного использования вычисленных данных.
При пороге 0,24 NVIDIA получила следующие результаты:
| Разрешение | Base | Distilled |
|---|---|---|
| 1024 × 1024 | 1,97× | 1,26× |
| 2048 × 2048 | 1,94× | 1,20× |
Чтобы оценить изменение изображений, NVIDIA использовала метрику LPIPS, которая измеряет перцепционные различия между двумя результатами. Чем меньше значение, тем ближе изображения согласно этой метрике.
Например, Cache-DiT при разрешении 2048 × 2048 обеспечила для Base ускорение в 1,94 раза при LPIPS 0,033 относительно варианта без кеширования.
Но LPIPS не показывает процент потери качества и не гарантирует отсутствие артефактов. Даже небольшое числовое отклонение необходимо сопоставлять с визуальным результатом и задачей генерации.
Как запустить FLUX 3 Image Klein через TensorRT LLM VisualGen
NVIDIA опубликовала инструкции, позволяющие воспроизвести основные варианты настройки. Примеры ориентированы на серверные GPU Blackwell и соответствующую программную среду. Для сравнения с официальными результатами необходимо учитывать используемые модели, разрешение и параметры генерации.
1. Подготовка контейнера
Для начала необходимо подготовить систему с поддержкой NVIDIA Container Toolkit и доступом к совместимому GPU. NVIDIA предлагает использовать специальный контейнер TensorRT LLM:
docker run --rm -it --ipc=host --gpus all -p 8000:8000 \
  --name tensorrt_llm \
  -e TLLM_FMHA_LIBS=+prims_ts \
  -e HF_TOKEN=<your_hf_token> \
  -v ~/.cache:/root/.cache:rw \
  nvcr.io/nvidia/tensorrt-llm/release:feat-flux3-image-klein-1.4.0a0.dev202610280436
Вместо <your_hf_token> указывается собственный токен Hugging Face. Переменная TLLM_FMHA_LIBS=+prims_ts активирует ядра внимания PrimsTS, необходимые для VC-Attention.
Приведённый образ относится к конкретной тестовой сборке, использованной NVIDIA. Это важно для воспроизводимости результатов, поскольку параметры и совместимость программной среды могут измениться в следующих версиях.
2. Запуск генерации изображения
После запуска контейнера нужно перейти в каталог примеров VisualGen и выполнить команду:
cd /app/tensorrt_llm/examples/visual_gen

python models/flux3.py \
  --model black-forest-labs/flux-3-image-klein-base \
  --visual_gen_args configs/flux3-images-1gpu.yaml \
  --prompt "A small robot tending a rooftop garden at sunrise" \
  --height 2048 --width 2048 --seed 0 \
  --output_path flux3.png
Команда запускает FLUX 3 Image Klein Base и сохраняет изображение в файл flux3.png.
Для использования NVFP4 на Blackwell добавляется параметр --variant nvfp4. Режим FP8 выбирается через --variant fp8r, а без указания варианта используется BF16.
Чтобы запустить Distilled, нужно заменить название модели на black-forest-labs/flux-3-image-klein. Для редактирования готового изображения используется параметр --image с путём к исходному файлу. Если нужны несколько изображений-образцов, этот параметр можно повторять.
3. Настройка Sol-Attention и Cache-DiT
Оптимизации задаются через YAML-файл. В одном из примеров NVIDIA объединяет квантование NVFP4, компиляцию, разреженное внимание и кеширование.
pipeline_config:
  variant: nvfp4
torch_compile_config:
  enable: true
compilation_config:
  resolutions: [[2048, 2048]]
  num_frames: [1]
  modes: [t2i, i2i]
attention_config:
  backend: TRTLLM
  sparse_attention_config:
    algorithm: sol_attn
    tau: 1.0
    disabled_until_timestep: 0.96
cache_config:
  cache_backend: cache_dit
  Fn_compute_blocks: 1
  Bn_compute_blocks: 0
  max_warmup_steps: 4
  max_continuous_cached_steps: 3
  residual_diff_threshold: 0.24
Значение disabled_until_timestep: 0.96 соответствует сохранению первых 12 полных шагов внимания для Base с 50 шагами удаления шума. Для Distilled с 16 шагами оно сохраняет первые четыре полных шага при используемом расписании.
Если для Base важнее точность результата, NVIDIA предлагает значение 0.94, соответствующее 16 первым полным шагам. При этом параметр задаёт порог уровня шума, а не буквальное число шагов.
Для работы с Sol-Attention без кеширования можно удалить раздел cache_config. Готовый пример также доступен в официальном YAML-файле NVIDIA.
Сохранённую конфигурацию нужно передать через параметр --visual_gen_args, заменив путь к стандартному файлу в команде запуска. Для сопоставления с опубликованными результатами следует сохранить разрешение 2048 × 2048 пикселей.
4. Запуск сервера генерации изображений
TensorRT LLM VisualGen позволяет не только запускать модель непосредственно из командной строки, но и предоставлять к ней доступ через API, совместимый с форматом OpenAI.
Для запуска сервера NVIDIA использует команду:
cd /app/tensorrt_llm/examples/visual_gen

trtllm-serve black-forest-labs/flux-3-image-klein-base \
  --host 0.0.0.0 --port 8000 \
  --visual_gen_args configs/flux3-images-1gpu.yaml
После запуска становится доступен интерфейс генерации изображений /v1/images/generations. Это позволяет подключать к модели внешние приложения, в том числе системы автоматизированной обработки изображений.
Для использования NVFP4 при серверном запуске NVIDIA рекомендует указать соответствующий вариант в YAML-конфигурации.
Что даёт запуск FLUX 3 Image Klein на нескольких GPU
Для распределения вычислений между видеокартами TensorRT LLM VisualGen поддерживает два механизма: CFG parallelism и Ulysses sequence parallelism.
В случае Base положительные и отрицательные ветви CFG распределяются между группами GPU, а последовательности внутри них обрабатываются с помощью Ulysses.
Для восьми NVIDIA B200 применяется следующая конфигурация:
parallel_config:
  cfg_size: 2
  ulysses_size: 4
Для Distilled, которая не использует CFG, указываются cfg_size: 1 и ulysses_size: 8.
В испытаниях на восьми B200 время генерации Base при разрешении 2048 × 2048 сократилось с 14,90 до 3 секунд. Distilled ускорилась с 2,73 до 1,08 секунды.
При этом непосредственно удаление шума ускорилось в 6,01 раза для Base и в 4,44 раза для Distilled. Разница объясняется тем, что текстовая подготовка, декодирование и другие этапы не получают такого же ускорения при добавлении GPU.
Для разрешения 1024 × 1024 NVIDIA также исследовала CUDA Graphs. Эта технология уменьшает накладные расходы на запуск вычислительных операций.
На восьми B200 применение CUDA Graphs снизило время генерации Base с 1,823 до 0,809 секунды, а Distilled — с 0,791 до 0,366 секунды. Это результаты отдельного эксперимента с NVFP4 и стандартным механизмом внимания.
Итоговые результаты тестирования NVIDIA
Главное сравнение NVIDIA охватывает весь процесс генерации изображения, а не только работу диффузионного трансформера. Базовым вариантом служила конфигурация BF16 со стандартным механизмом внимания без компиляции.
На одной NVIDIA B200 при разрешении 2048 × 2048 пикселей для FLUX 3 Image Klein Base получены следующие результаты:
| Операция | До оптимизации | После оптимизации | Ускорение |
|---|---|---|---|
| Генерация по тексту | 22,36 с | 6,46 с | 3,46 раза |
| Редактирование изображения | 54,64 с | 12,28 с | 4,45 раза |
Эти показатели достигнуты совместным применением компиляции, NVFP4, PrimsTS GEMM, Sol-Attention и Cache-DiT. Для Distilled NVIDIA сообщает об ускорении полного процесса до 2,34 раза.
Дополнительные испытания на NVIDIA RTX PRO 6000 Blackwell Server Edition показали ускорение от 1,73 до 3,25 раза. В этой конфигурации применялись компиляция, NVFP4, оптимизированные вычислительные ядра CuTe DSL и Cache-DiT.
Однако результаты нельзя автоматически переносить на потребительские видеокарты GeForce RTX. NVIDIA не представила в этом руководстве измерений FLUX 3 Image Klein на игровых GPU. Реальная скорость будет зависеть от видеокарты, объёма памяти, программной среды, разрешения и параметров модели.
Кроме того, приведённые значения не включают время на дополнительное расширение текстового запроса средствами Black Forest Labs, если такой этап используется отдельно.
Есть и ограничение, связанное с качеством изображений. В опубликованном сравнении последовательных оптимизаций для Base итоговый LPIPS относительно исходного варианта BF16 достигал 0,095 при генерации по тексту и 0,045 при редактировании. Поэтому максимальное ускорение не означает полного совпадения изображений с результатами базовой конфигурации.
Для разработчиков NVIDIA подготовила пример запуска FLUX 3 в TensorRT LLM и отдельные конфигурации для различных способов оптимизации.
Результаты показывают, что производительность генеративной модели определяется не только мощностью оборудования. Правильная организация вычислений, квантование и повторное использование промежуточных данных способны существенно сократить время обработки. Но подходящую конфигурацию необходимо выбирать с учётом конкретной задачи, доступных GPU и требований к визуальному результату.